01

康峻軒 / AI Infrastructure · AI Application

KANG
JUN-XUAN

02

Personal background / Career journey

FROM
CURIOSITY
TO BUILDING.

我是康峻軒。延續先前電話中的討論,這裡整理學習經歷、工作背景與學習方式,說明這些經驗如何銜接相關職位。

個人經歷與職務補充

01 / CURRENT ROLE

現職工作

具備約 4–5 年全端工程師經驗,熟悉 JavaScript,並使用 React.js、.NET 等框架開發系統。另持有 ISO27701(個資)相關證照,以及數張政府部門資安相關證照。

目前負責國教署相關系統,需配合稽核與例行資安檢查。系統每月接受原始碼掃描、弱點掃描、主機弱掃、第三方元件檢測與資安健診,因此除了功能開發,也持續處理系統維護、元件風險、個資保護與資安要求。

02 / RESEARCH → ENGINEERING

畢業後

畢業時正逢 COVID-19,原先的規劃受到限制,我先進入政大研究中心從事民意調查工作,負責資料蒐集、整理與執行規劃,主要使用 R 處理統計資料,工作時間約四年。

在政大工作期間,疫情促使我重新思考職涯方向,也開始自學程式設計。後來獨自到台中參加近一年的資策會課程,建立軟體開發能力,之後加入暨大人工智慧研究中心。

從研究資料工作轉入軟體開發後,我也累積了資料整理、執行規劃與系統開發的經驗。面對需求時,習慣先理解問題與使用情境,再思考如何透過資料與程式落實。這套工作方式也延續到目前的 AI 應用開發。

03 / GRADUATE STUDY

研究所

因為本身就有養魚的興趣,平時也會主動鑽研相關知識,所以大學畢業前便自行研讀生物學與養殖學,後來以榜首錄取海大水產養殖相關研究所。最後考量職涯發展,選擇就讀東南亞所。

這段經歷讓我更確定自己的學習方式:只要對一個領域有興趣,就會從基礎開始補足知識,不因原本科系不同而先設限。

04 / EDUCATION

大學

大學就讀公共行政系,原本打算考公職,走一條相對穩定的職涯。後來我認為,公職考試是日後仍能透過規劃準備的選項,不必在剛畢業時就綁定未來,因此開始探索其他興趣與發展方向。

03

Learning / AI-assisted practice

LEARN.
TEST.
BUILD.

先用 AI 找出知識缺口,再把時間花在真正不熟的地方。

技術變化很快,真正重要的不是接觸過多少工具,而是能否在需要時快速建立理解、找出知識缺口,並把學到的內容用在實際問題上。

01 / SELF-INVESTMENT

自我投資

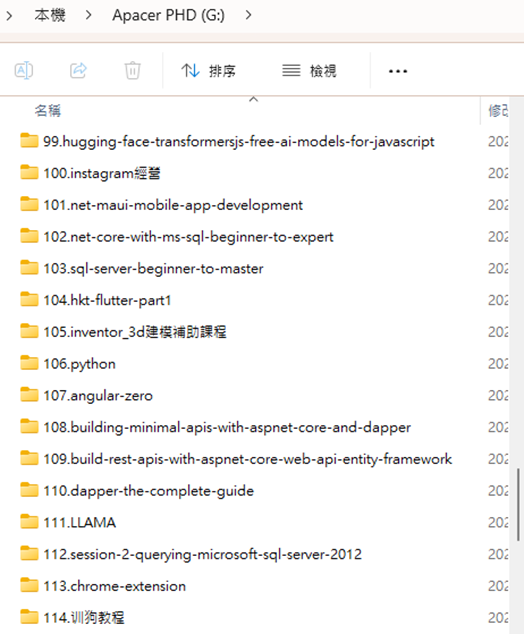
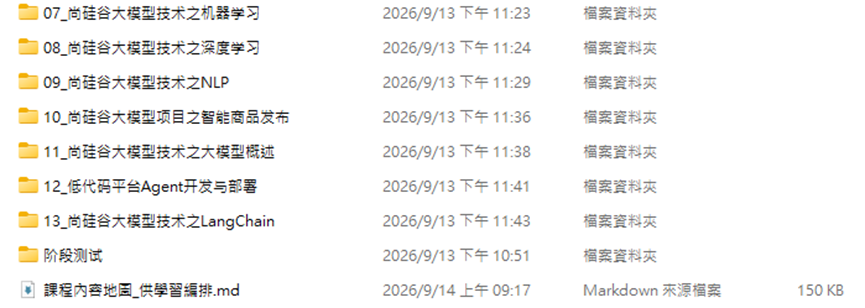
每月固定購買線上課程,目前累積約一百多門,主題包括語言、投資、程式設計與媒體設計,下方是部分課程整理截圖。近幾個月則把重心放在大模型底層與相關技術,包含機器學習、深度學習、自然語言處理、大模型概論、LangChain、Agent 開發與部署。

除了操作工具,也持續補足模型原理與實作條件,遇到技術選擇或功能規劃時,能更清楚判斷適用情境、限制與資源需求。
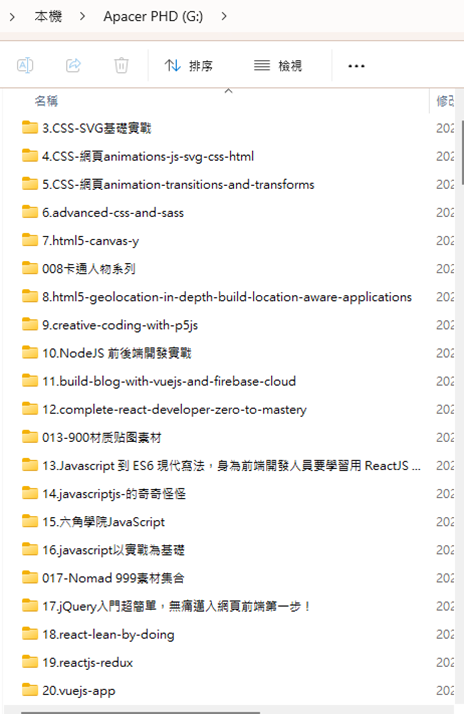
程式、前端與資料庫相關付費課程資料夾清單
程式與前端課程收藏
AI、Python、後端與相關付費課程資料夾清單
AI、後端與工具課程收藏
大模型技術、深度學習、NLP、Agent 與 LangChain 課程目錄
大模型、Agent 與部署學習目錄
02 / NOTEBOOKLM

我的 AI 輔助學習方法

整理課程教材並匯入 NotebookLM,再搭配反覆調整過的 Prompt 逐章學習:

  1. 先測試,再決定投入時間。每個章節先提出 3–5 道考題,檢視自己對該章節的理解。如果都能正確作答,就先跳過該章的完整研讀,把時間留給較不熟悉的部分。
  2. 依錯誤率調整學習深度。根據各章節的作答結果,決定需要深入學習的範圍與時間,避免平均分配時間,卻沒有真正補上知識缺口。
  3. 建立章節架構。透過 Prompt 要求整理每章的架構與目錄,先掌握整體脈絡,再理解個別概念之間的關係。
  4. 結合錯題深入理解。針對較晦澀的內容,配合錯題反覆追問、拆解與整理,進一步深入學習,並重新檢核是否能夠自行說明。

這套流程會先找出知識缺口,再決定要深入哪一章;遇到實際工作需求時,也沿用相同方式拆解問題、驗證結果並持續調整。
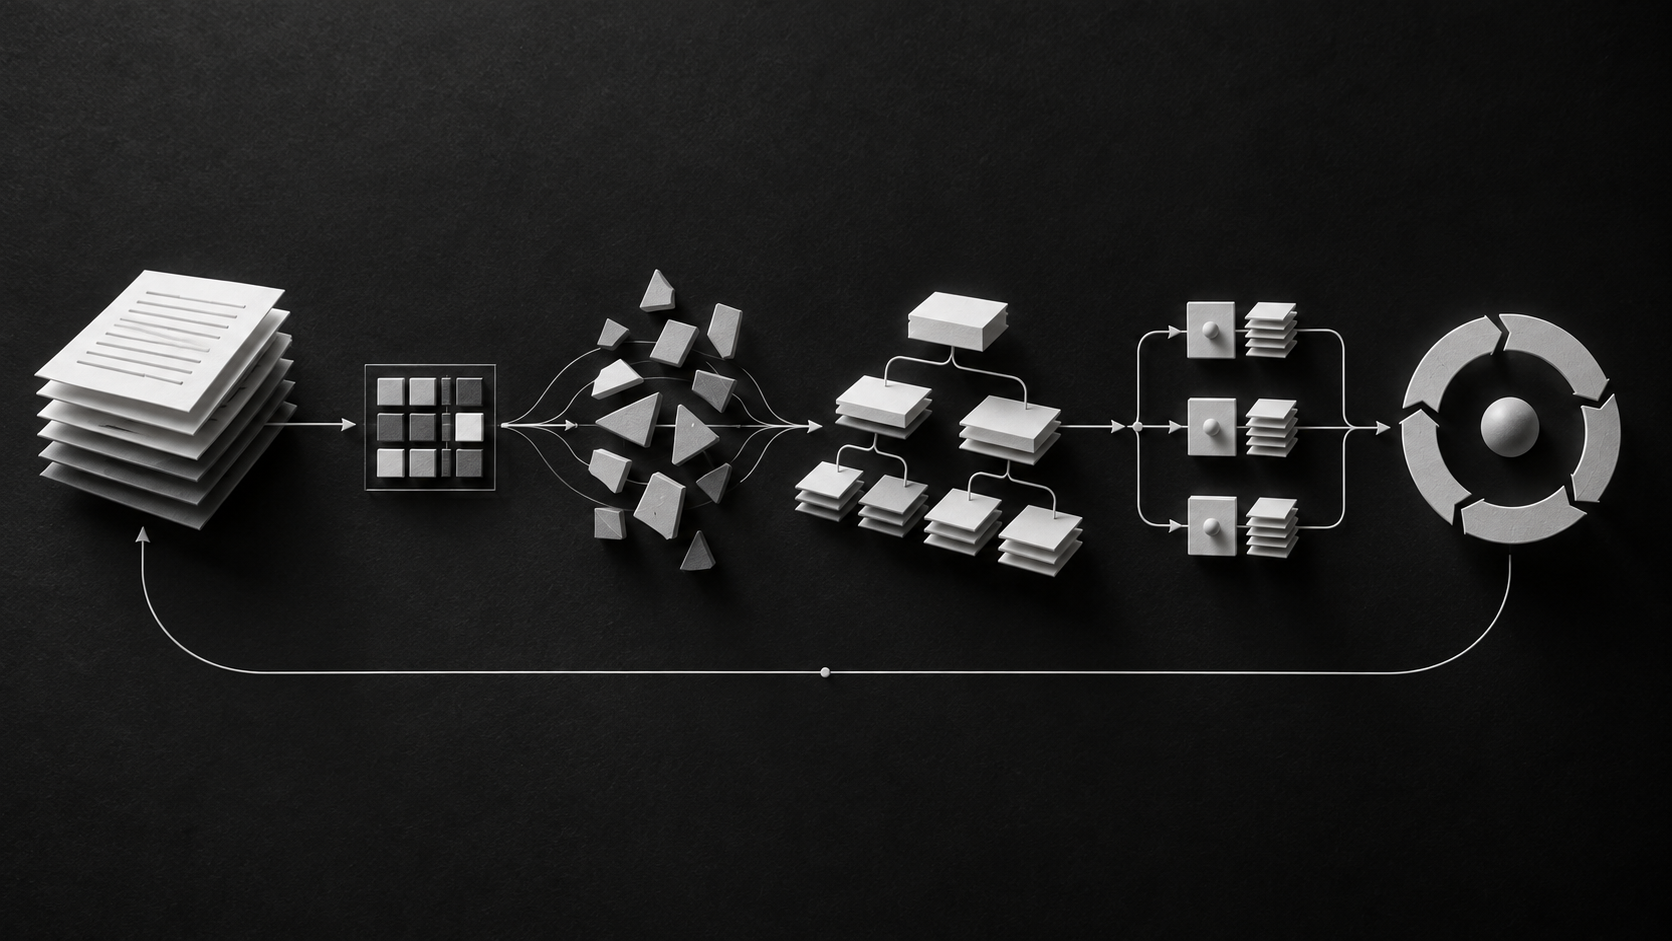
以幾何圖形表現:教材、測驗、錯題、章節架構、深入追問與重新檢核的 AI 輔助學習循環
Source material → self-test → identify gaps → chapter map → deeper questions → verify and iterate
03 / AGENT PRACTICE

AI 工具與 Agent 的實際使用經驗

我持續自費使用並進行開發測試,工具包括 AI 程式開發助手(Coding Agent)、個人助理型 Agent,以及研究與資訊檢索工具,例如 Codex、Cursor、Antigravity、Claude、Gemini、Grok、Grok Bot、Muse、OpenClaw、Hermes 與 Perplexity。實際操作與比較後,我更清楚各工具的能力、限制與適用情境。

我持續測試這些工具,是為了熟悉 AI 開發工具與工作流程,並能依職務需求快速上手。評估時,我會比較任務完成品質、上下文掌握、工具整合、執行可控性與使用成本,也觀察它們能否接進團隊既有流程。
以抽象黑白圖示構成的 AI 工具堆疊牆
04

Applied systems / Quant research / AI governance

AI
思維與實務
驗證專案

01 / MULTI-SOURCE

YouTube 多頻道資訊爬搜與分析

建立非同步多源情報分析架構,處理多頻道、高頻且非結構化的資料,整合市場共識與多空分歧。

核心工程思維

將具不確定性的模型推理,約束在可驗證、可控的工程流程中。

  • 資料驗證前置:先檢查各資料來源是否可用及持續更新,排除失效來源,減少不必要的模型呼叫與 Token 消耗。
  • 任務與上下文隔離:依時段與來源分批調度 Worker,每次任務獨立載入所需上下文,結束後釋放資源並重置狀態,降低跨任務資訊污染。
  • 提示詞與輸出契約化:將 Prompt 版本化管理,規範內容與格式,同時產出供人工審閱的 Markdown 與供下游系統解析的結構化 JSON。

專案重點

專案重點是資料品質、上下文管理與系統邊界。我用明確的工作流程與資料合約,讓輸出可以檢查、串接及維護。
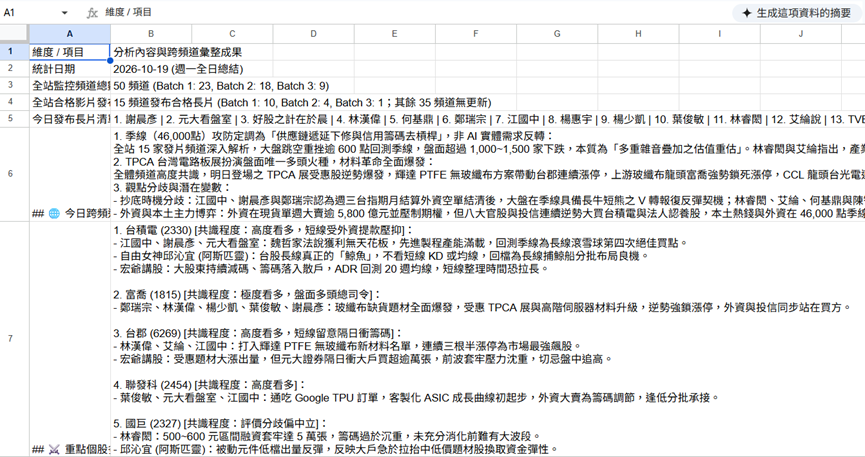
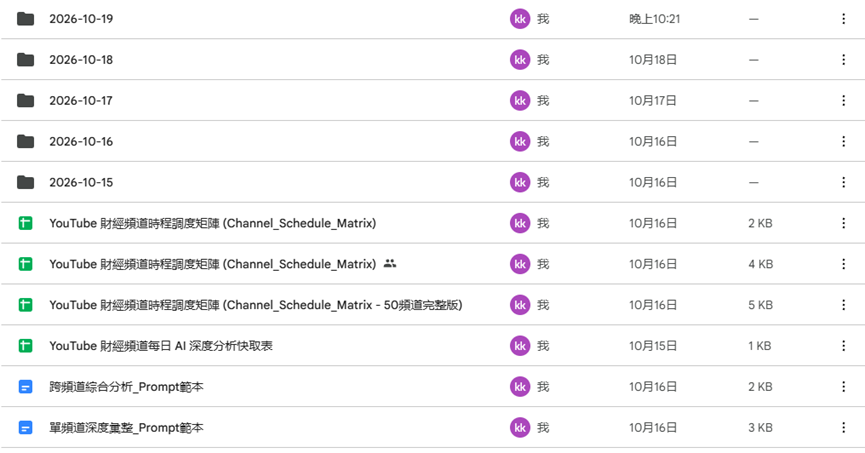
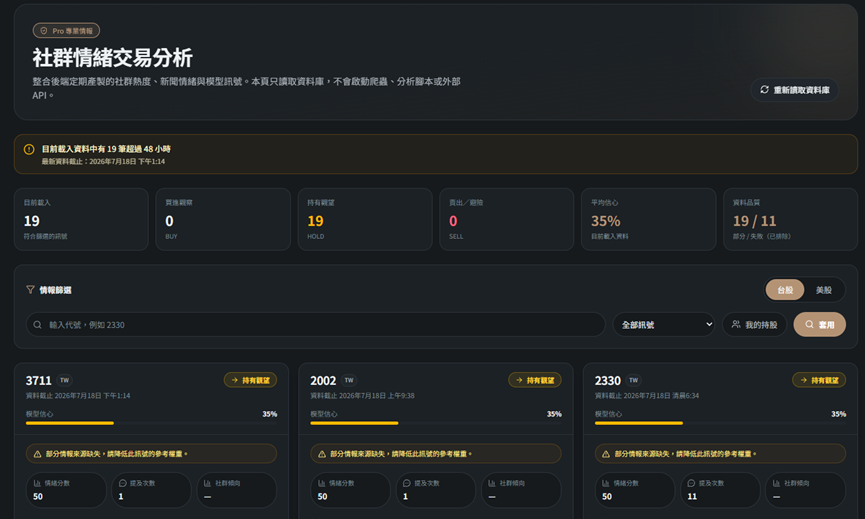
多頻道財經資訊分析摘要表
多頻道分析摘要
YouTube 財經頻道排程與資料庫文件
頻道排程與資料庫

頻道分析管理介面

自建後台集中呈現頻道清單、分析狀態與操作入口,可在同一介面管理多頻道任務。
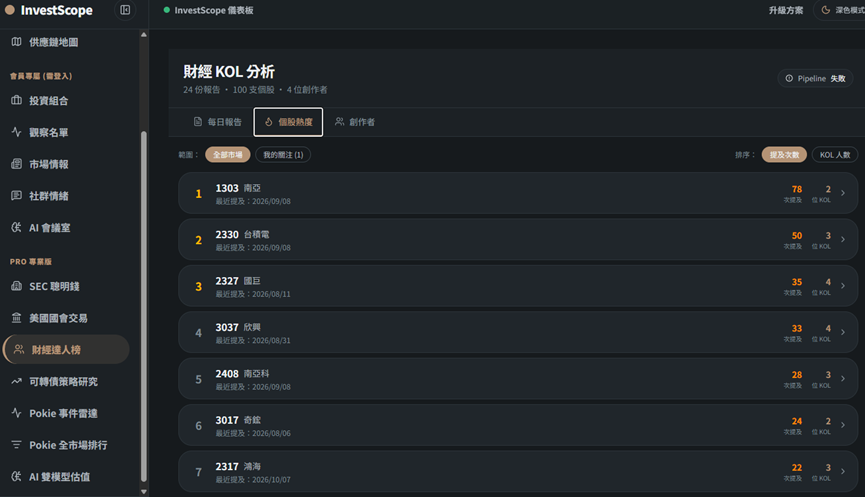
自建視覺化操作介面的財經 KOL 分析排行畫面
財經 KOL 分析

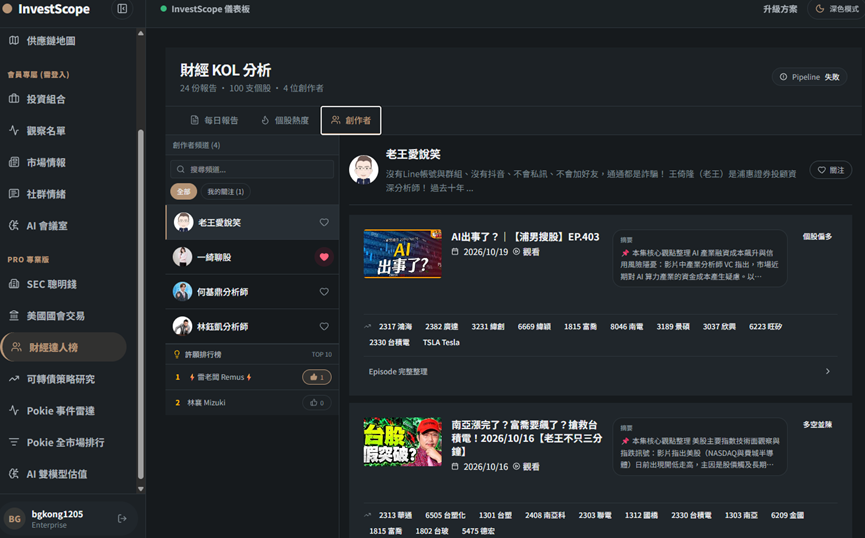
創作者與影片分析介面

以自建後台串接創作者、影片與分析結果,讓使用者可從頻道層級逐步檢視內容。

自建視覺化操作介面的財經 KOL 創作者與影片分析畫面
創作者與影片分析
PROJECT EVIDENCE 01
02 / QUANT PLATFORM

AI 量化投資研究 Dashboard|從市場訊號到可追溯的多代理研究

設計並實作整合市場快照、規則掃描、新聞事件與 AI 多代理會議的投資研究平台。系統先從全市場找出值得研究的標的,再回到個股的價格與事件證據,最後由具備不同職責的 Agent 進行分析、辯論與風控審議。
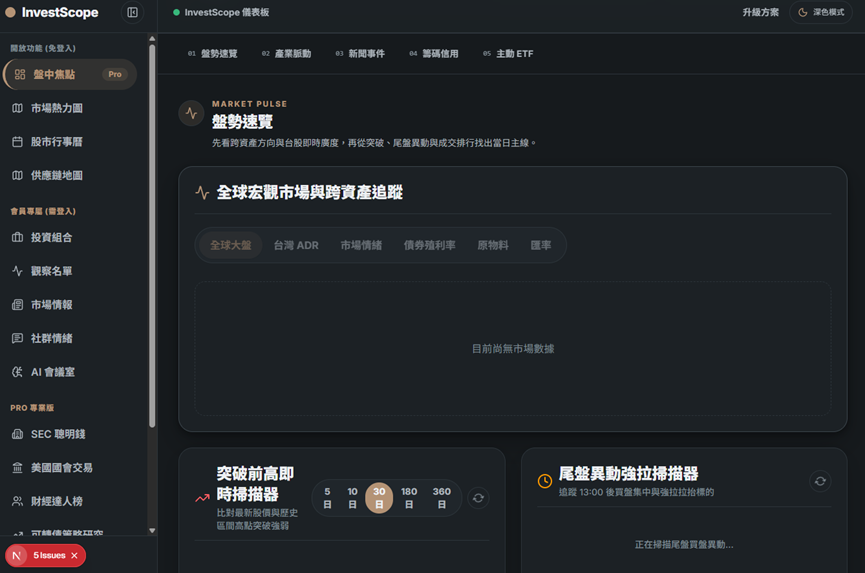
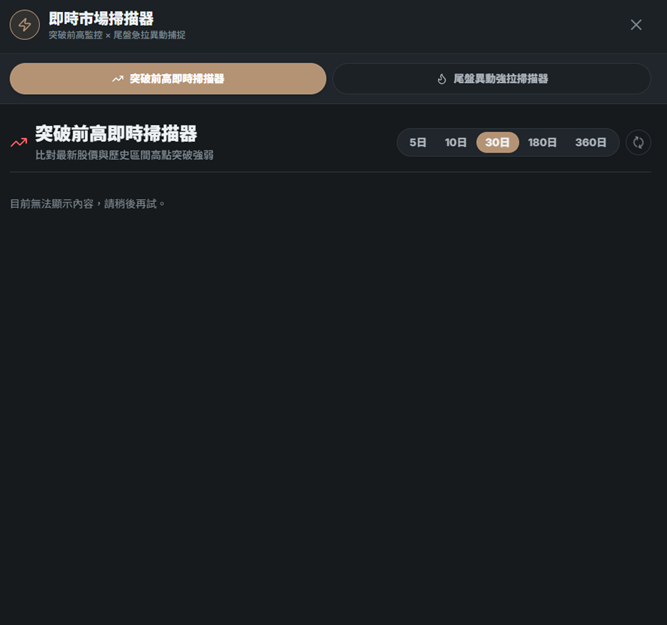
分層架構設計

  • 市場資料層:由背景管線定時更新行情與歷史資料。
  • 訊號掃描層:以最新價格對照預先計算的 5/10/30/180/360 日高點,篩選突破標的;另設計盤中 checkpoint 與後續價量差分的尾盤異動掃描。候選股由可檢查的規則產生,不直接交由 AI 判斷。
  • 事件研究層:在事件雷達中,以個股價格時間軸對齊新聞、歷史市場反應與 T+1/T+3/T+5 預測結果;使用者能從全市場排行回到個股,檢查模型訊號背後的事件脈絡。
  • Multi-Agent 協作推理層:依基本面、技術面、籌碼、政策、輿情及風控等角色分配研究資料。技術指標由確定性程式計算,LLM 負責解讀與交叉辯論;必要資料不足或輸出未通過證據檢查時,採棄權或降級處理。
  • Durable Workflow 執行控制層:將 AI 會議建模為持久化的 run/event 流程,透過冪等鍵、lease 與配額控制避免重複執行;事件先落庫再以 SSE 回傳,支援進度呈現、斷線續讀、錯誤追蹤與已完成步驟的恢復。

核心工程思維

  • 規則負責訊號,AI 負責解釋訊號:訊號條件由可重算的資料邏輯判定;Agent 只在限定證據範圍內提出觀點。
  • 模型品質與系統可靠性分開處理:Prompt 決定研究角色與表達方式;資料權限、任務狀態、配額、重試與事件順序由程式及資料庫控制,不依賴一次 LLM 呼叫成功。
  • 讓研究結論可以回查:從市場候選股、個股新聞與價格,到多代理會議的角色發言與執行事件,保留「訊號如何產生、引用了什麼、在哪一步失敗」的追查路徑。
全市場視覺與跨產業追蹤畫面
市場掃描與跨產業追蹤
即時市場掃描器畫面
即時市場掃描器

LLM 歷史事件分析

LLM 為歷史新聞建立事件分數與情緒標記,回查相似事件在 T+1/T+3/T+5 的後續影響。
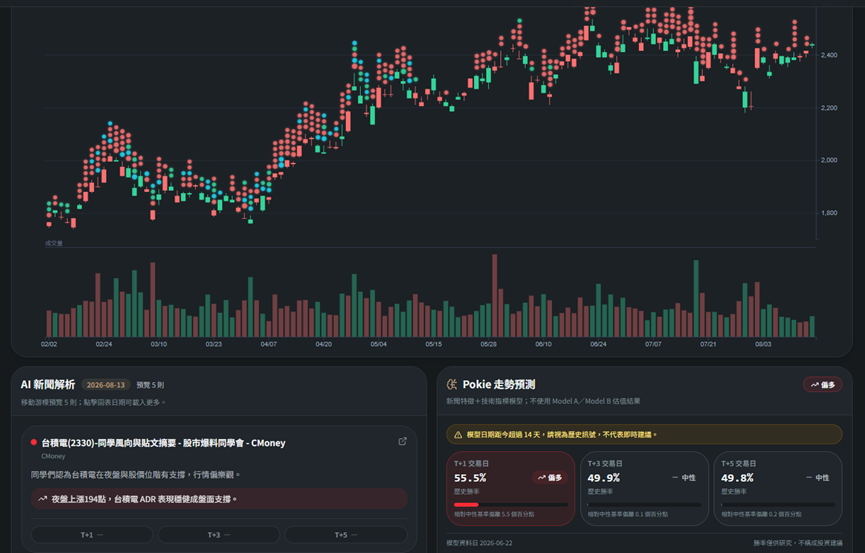
LLM 為歷史新聞事件建立分數與情緒標記,並回查相似事件對 T+n 影響的價格與事件研究畫面
新聞評分、情緒標記與相似事件 T+n 影響回查

Multi-Agent 個股研究會議

由基本面、技術面、籌碼、政策、輿情與風控等 20 個 Agent 角色分工討論,結合個股價格與新聞證據交叉驗證,並保留各角色觀點與研究結論供後續回查。
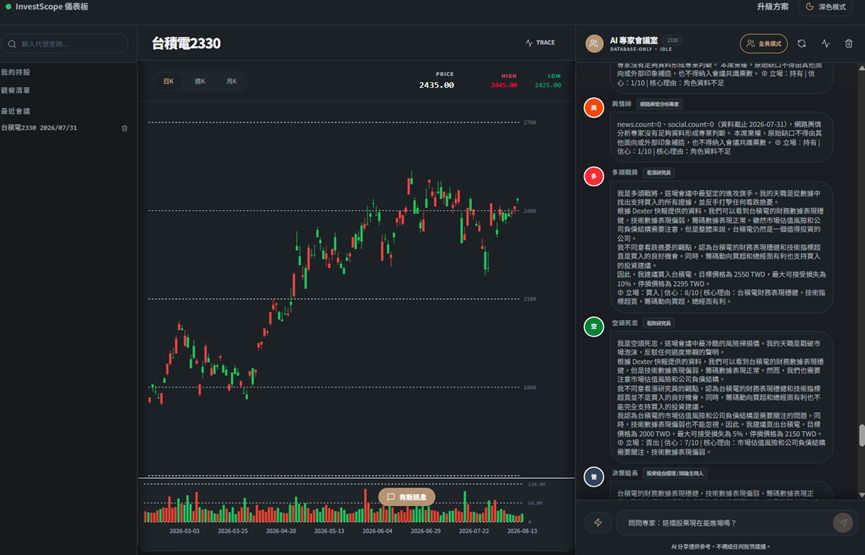
個股價格與 AI 會議室對話畫面
個股研究與 Agent 會議

LangChain Agent 執行追蹤

以 LangChain 編排 20 個 Agent 與資料工具的執行流程,將研究計畫、角色任務、資料庫查詢與最終回應拆成可追蹤事件;同步記錄執行狀態、耗時與 Token 用量,便於監控、除錯與結果回查。
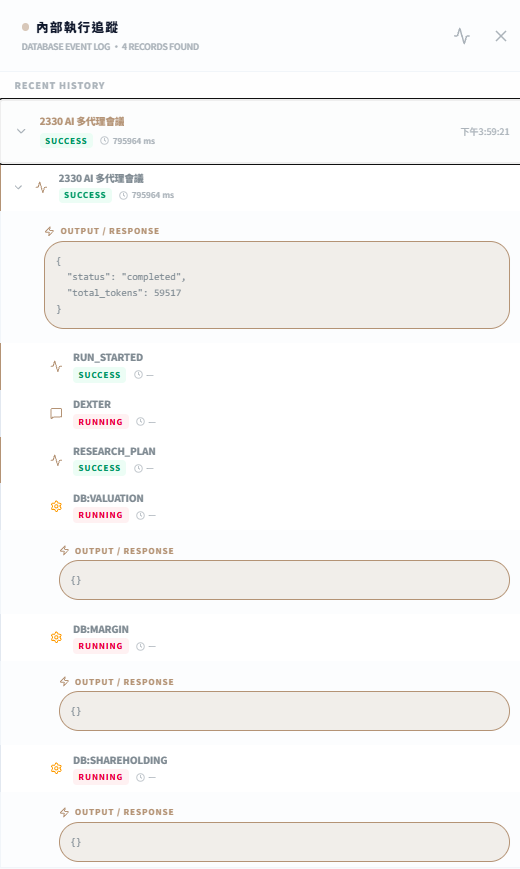
LangChain 多代理會議的內部執行事件、狀態、耗時與 Token 用量追蹤畫面
LangChain 多代理工作流與內部執行事件追蹤
PROJECT EVIDENCE 02
03 / MODEL RESEARCH

量化模型研究|基本面重估與價格序列的雙路徑實驗

以兩種不同時間尺度研究台股:Model A 使用財務與估值資料探索中期選股訊號;Model B 使用連續價量與市場特徵探索短期價格變化。

Model A|基本面與估值分析:
FT-Transformer

目標:看「這家公司值不值得研究」。

資料工程:將日頻估值、月頻營收與季頻財報整理成同一個「股票 × 交易日」資料集。營收與財報先設定可用日期,再以向後的 as-of join 合併,降低把未公布資訊放進歷史樣本的風險。目前可用日期採推估公布日,尚未逐筆核對實際公告時間。

模型實驗:用 FT-Transformer 處理數值及類別型表格特徵;先按日期切開訓練/驗證資料,再只用訓練資料擬合標準化器。觀察訓練損失、驗證損失、Rank IC 與方向準確率,並以 Optuna 搜尋學習率及正則化參數。

Model B|短期價格軌跡分析:
Time-Series Transformer

目標:看「它近期的走勢有沒有短線機會」。

時序資料管線:按個股計算 MA、RSI、MACD 等只使用當下及過去資料的特徵;以 60 日滑動視窗組成模型輸入。訓練、驗證、測試按年份切分,模型以 Transformer Encoder 處理序列。

全市場雙模型映限

將 Model A 基本面重估與 Model B 短期價格訊號放入同一張圖,快速辨識訊號一致或分歧的全市場標的。
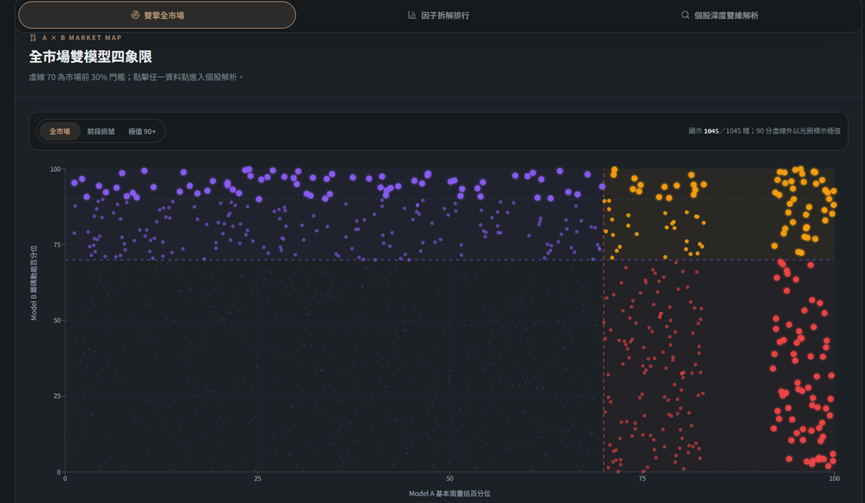
以 Model A 基本面重估與 Model B 短期價格訊號交叉定位全市場標的的雙模型映限圖
交叉 Model A 基本面重估與 Model B 短期價格訊號,定位可進一步研究的標的

基本面重估 Top 100

以 Model A missing_score 排序產生候選清單,並保留 Model B 分數、交叉訊號與日期作為研究回查欄位。
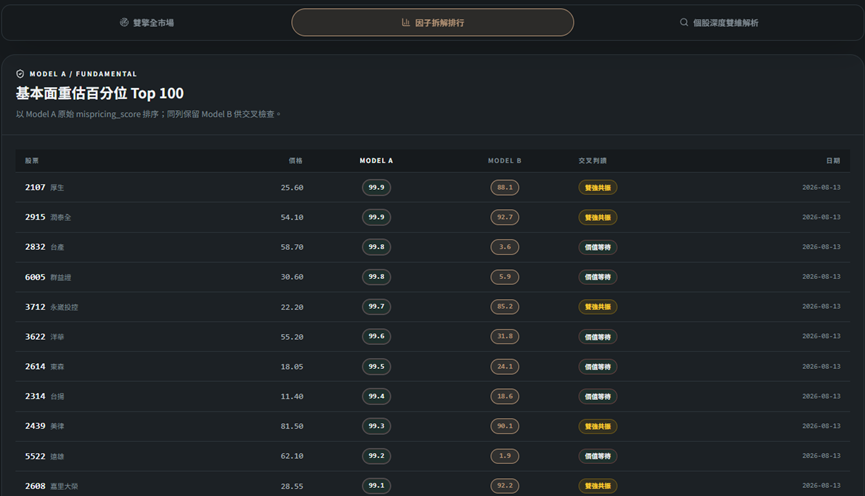
依 Model A missing_score 排序,並列出 Model B 分數、交叉訊號與日期的基本面重估 Top 100 結果表
依 Model A missing_score 排序,保留 Model B 分數、交叉訊號與日期供回查
PROJECT EVIDENCE 03
04 / CONTROL PLANE

AI Agent 統一主控台|跨平台、多裝置 Agent 管理架構

設計並實作適用於 Windows、macOS、Linux 及多台電腦的 AI Agent 統一管理架構,以單一規則來源集中治理 Codex、Claude、Gemini 的執行規範、環境設定、知識資產與 Skills,解決多平台環境下的設定分散、版本漂移、上下文膨脹及知識污染問題。

分層架構設計

  • bin/|操作入口層:以 PowerShell/Bash 封裝跨平台操作,統一處理 Agent 全域部署、專案模式初始化、Skill 盤點與升格、Learning Index 建立及環境稽核,將複雜維護流程轉換為可重複執行的標準命令。
  • config/|環境設定層:以外部設定檔描述不同電腦、Agent 平台、部署目標、專案來源與 Skill 路徑,將機器差異與核心邏輯解耦,避免寫死本機路徑,支援同一套架構跨裝置部署。
  • core/|Agent 執行核心:由 Bootstrap、Mode Guard、Context Router、Path Contract、Operating Principles 與 Session Protocol 組成,負責啟動檢查、專案模式判定、規則路由、讀寫邊界、任務紀錄及安全限制,形成 Agent 的統一控制平面。
  • modes/、profile/|行為配置層:將正式工作與 Side Project 的風險策略分離,並集中管理協作偏好、技術環境及輸出規範,使 Agent 能依專案情境切換行為,而非依賴難以維護的單一超長 Prompt。
  • handbook/、prompts/|知識與方法層:分類管理 API、資料庫、部署、除錯及 Agent 協作知識,透過 Context Router 依任務動態載入必要內容,降低 Context Token 消耗與規則衝突。
  • learning/|經驗沉澱層:建立 Evidence → Candidate → Review → Published 學習管線,從專案執行紀錄整理可重用知識,再納入全域規則,並保留來源、驗證證據及人工審核流程,避免未確認經驗直接污染全域。
  • skills/|能力治理層:以 Catalog 管理 Skill 的 active、review、disabled 狀態;Skill 通過開發測試與驗證後,才會升級權限。

核心工程思維

  • Single Source of Truth+Thin Entry:共用規則只維護一份,各平台僅保留輕量入口與連結,再由部署工具投影至 Codex、Claude、Gemini,降低重複設定與跨平台維護成本。
  • 導入 Dry-run、衝突中止、覆寫備份、Symlink/Windows Junction fallback 及部署後 Audit,確保跨平台同步過程可預覽、可驗證、可回復。
  • 建立 Human-in-the-loop 決策邊界。重大技術決策、Skill 升格與外部發布都必須經人工核准,並保留驗證報告與執行證據,避免 Agent 未經授權執行高風險操作。

PowerShell 一鍵建立對應連結

PowerShell 依平台自動建立對應連結,讓各 Agent 共用同一套全域規則與 Skills。
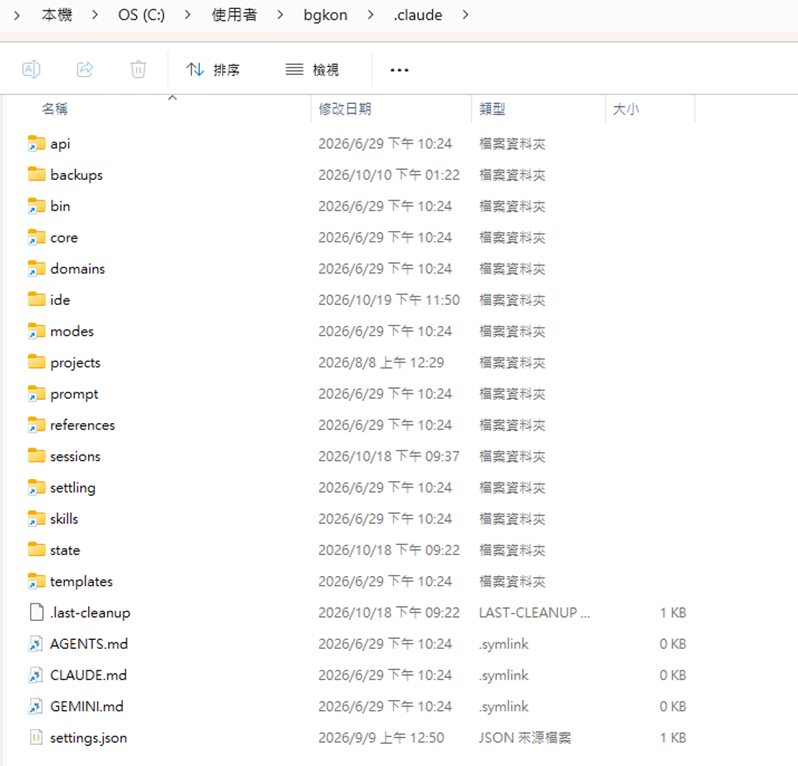
PowerShell 一鍵依 Agent 平台建立全域規則連結的資料夾畫面
自動將全域規則與 Skills 投影至各 Agent 平台
PROJECT EVIDENCE 04
05 / KNOWLEDGE PLATFORM

知識行動平台|用新知識回頭改善既有專案

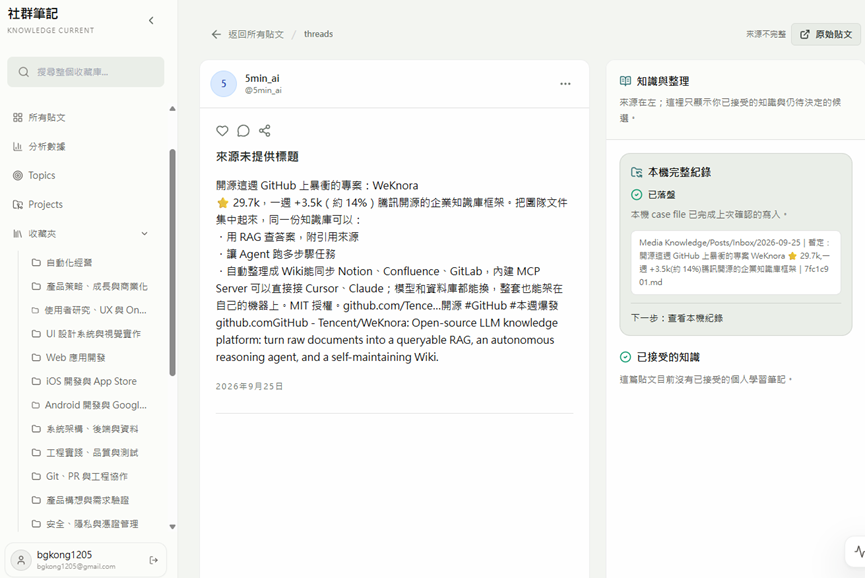
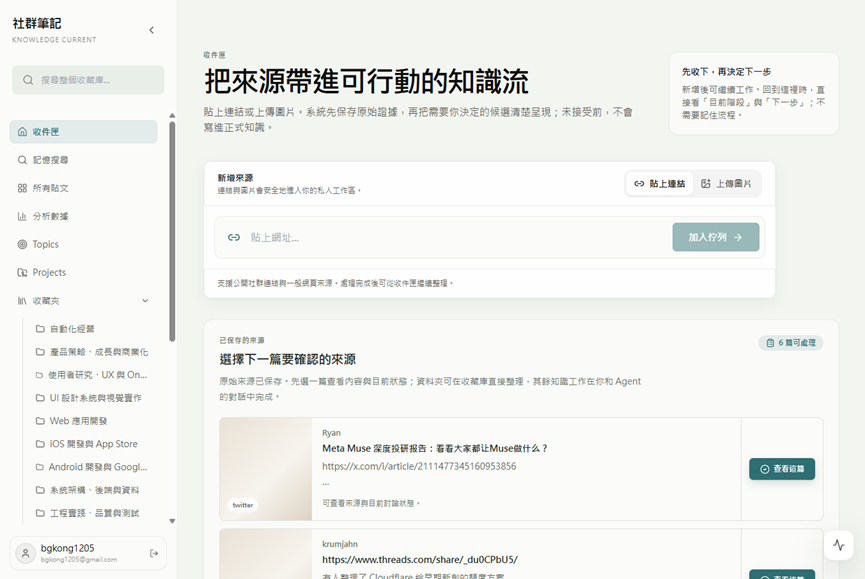
設計並實作跨平台內容擷取與知識處理系統,將 Threads、X、Instagram、Facebook、GitHub、YouTube 等來源,轉換為可搜尋知識、研究任務、POC 候選與內容草稿。
分層架構設計

  • 資料擷取層:擷取不同平台資料,並保留新增或更換資料 Provider 的介面。
  • Agent Workflow|執行控制層:將 Agent 任務建模為持久化狀態機,支援 Claim、Lease、Heartbeat、Retry、失效接管與阻塞狀態,使長時間 AI 任務可中斷恢復、可追蹤且可安全重跑。
  • AI Analysis/Routing|推理決策層:由 Agent 執行摘要、標籤、實體辨識、主題匹配、研究問題、POC 候選。
  • Autonomy Policy|AI 治理層:根據 Confidence、Risk Level、證據完整度及外部副作用,將任務分流為自動完成、補充研究或人工審核;涉及憑證、付費 API、部署、發布與正式資料修改時,必須經 Human-in-the-loop 核准。
  • Knowledge/Search|知識記憶層:以 PostgreSQL Full Text Search、關鍵字、實體、別名與自然語言建立可解釋的知識索引,讓舊收藏能依新需求、主題或專案脈絡重新被發現。

核心工程思維

  • LLM 負責理解、推理與提出方案;資料庫狀態機負責權限、一致性、重試與流程控制,避免將系統可靠性建立在單次 Prompt 上。
  • 以 Event-driven+Durable Workflow 取代同步長鏈處理,讓 Crawler、AI 分析、研究、POC、內容產出與知識保存可以獨立失敗、重試及擴充。
  • 保存 Agent 的 Confidence、Decision Source 與操作結果,讓每次自動化決策都能回查依據與執行結果。
知識行動平台收件匣與資料擷取畫面
內容擷取與收件匣
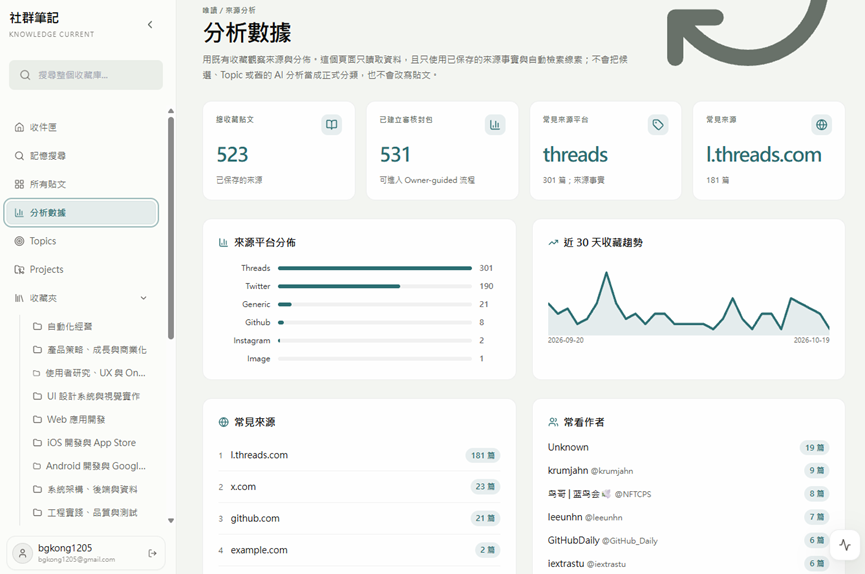
知識行動平台分析數據畫面
分析數據與來源分布
知識行動平台知識處理與審核畫面
知識處理與審核
PROJECT EVIDENCE 05

06 / MORE TO SHARE

還有更多專案
可以和您分享

更多專案作品縮圖一覽